
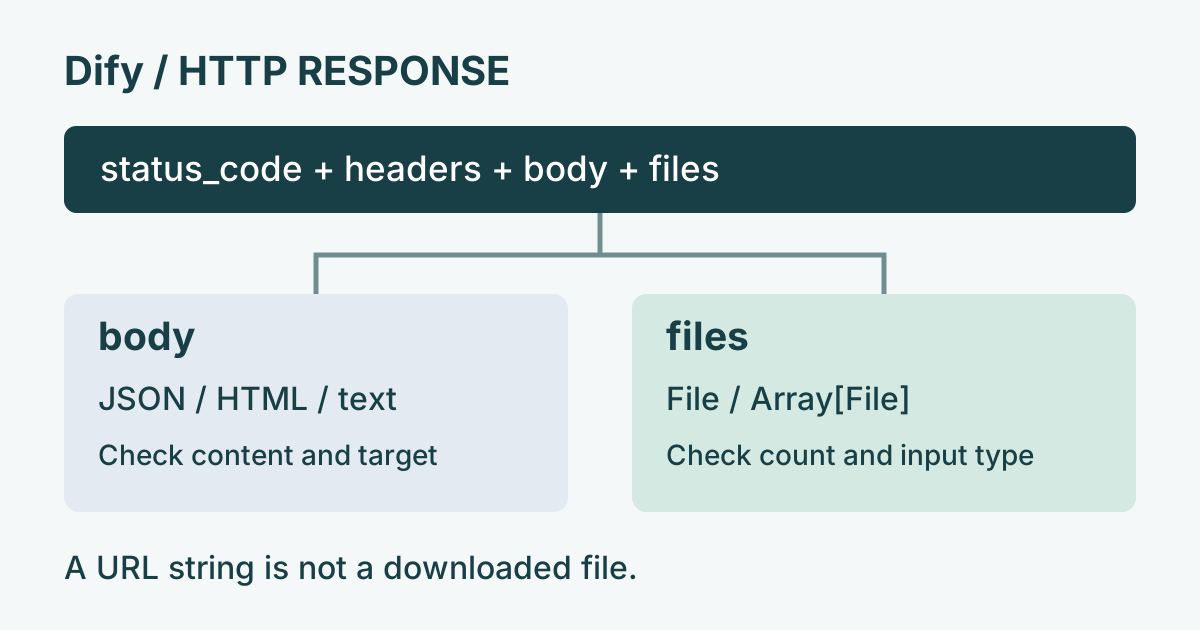
DifyのHTTPリクエストでfilesが空なら、最初に「ファイル本体を取得したか」を確認します。 PDFのURLが入ったJSON、閲覧ページのHTML、PDF本体は別の応答です。URLの末尾が.pdfでも、ファイル変数が得られたとは限りません。状態コード、応答ヘッダー、body、filesを一組で見てください。
対象は、Difyから文書を取得し、ドキュメント抽出器や後続の処理へ渡す練習を始めた人です。URL、HTTPの成功・失敗、文字列と配列という違いを確認しながら進めます。本稿では、既存のファイルを受け取る場面を扱い、ファイル生成サービスの契約や有料APIの利用は行いません。
公式資料の確認日:2026年11月1日。Dify Cloudの公式ノード資料を基にしています。後半のPythonは、確認手順を練習するための架空の観測データです。Dify内部のファイル判定を再実装したものではなく、Dify CloudでのHTTP実行やLLM利用は本稿の検証に含めません。
filesが空のとき、取得先・実際の応答・後段の型を分けて見る
ダウンロードURLが入ったJSONは、ファイル本体ではない
外部サービスが返すJSONには、文書の名前やダウンロード先URLだけが入ることがあります。この場合にHTTPリクエストが取得したのはJSONです。JSONの中へPDFのURLが書かれていても、そのPDFを取得し終えたことにはなりません。
例えば、ファイル一覧を返すAPIと、その一覧に載った一つのファイルを取得するAPIは役割が違います。一覧APIの呼び出しが成功していれば、bodyへJSONが返り、filesは空という結果でも不自然ではありません。まず、呼び出したAPIが何を返す仕様なのかを確認します。
この区別をせず、bodyの文字列をFile入力へ接続しても、内容が自動でダウンロードされるとはいえません。変数名をpdfへ変えたり、URL末尾へ.pdfを付けたりすることも、ファイル本体の取得とは別です。必要ならサービスの公式仕様に従って取得先を確認し、別の取得処理として設計します。
取得URLには有効期限や利用権限が付く場合もあります。文書の閲覧ページで開けることと、Difyの実行環境から取得できることを同じ扱いにしないでください。利用者のブラウザーに保存されたログイン状態が、そのままHTTPノードへ移るわけではありません。
状態コードだけでなく、Content-Typeとbodyも確認する
HTTP 200は、期待したPDFの中身が届いたことまで表してはいません。ログインを促すHTML、案内ページ、処理受付を表すJSONが200で返る場合もあります。成功コードだけを条件に、ファイルとして後段へ進めると、別の内容を処理しようとして失敗する可能性があります。
確認するのは、状態コード、Content-Type、Content-Disposition、body、filesです。bodyへHTMLが返ったなら、PDF解析器の設定を変更する前に、ファイル本体ではなくページを取得していないかを調べます。JSONなら、エラー情報なのか、ファイルを取得するための情報なのかをAPI仕様と照合します。
| 観測した応答 | まず考えること | 次の確認 |
|---|---|---|
| 2xx・filesにファイルあり | ファイルとして取得された | 件数・形式・後段の入力型 |
| 2xx・bodyにURL入りJSON | 取得先の情報を受け取った | API仕様と実際のファイル取得手順 |
| 2xx・bodyにHTML | ページを受け取った可能性 | 取得先・認証・閲覧ページとの違い |
| 2xx・bodyもfilesも空 | 空応答や対象なしの可能性 | 応答仕様・元の文書・結果の見方 |
| 401・403など | ファイル解析より前の問題 | 権限・アクセス方法・公式の利用条件 |
ヘッダーも、単独で正しい内容を保証するものではありません。期待する形式の名前が付いていても、実際の中身が違うことがあります。本文を確認するときは、機密文書全体を共有ログへ貼り付けず、機密を含まない確認用文書で再現できるかを先に試してください。
Difyは応答を判別するが、拡張子だけで決めない
DifyのHTTP Request公式資料は、Content-Disposition、MIMEタイプ、曖昧な場合の内容の確認を使って、応答を判別する仕組みを説明しています。JSONやHTMLなどのテキストと、ファイルとして扱う内容を区別します。
そのため、ファイルのURLに見えることや、Content-Typeの一項目だけを見て、どの出力へ入るかを決めつけない方がよいでしょう。実行結果のbodyとfilesの両方を確認します。ファイルとして認識された結果、bodyが空でも、filesに取得した内容がある場合があります。
反対に、filesが空だからノードの実行そのものが失敗したとはいえません。テキストの応答を受け取った可能性があるためです。ステータス、ヘッダー、各出力をひとまとめの観測結果として残すと、後段の接続不備と取得内容の違いを切り分けやすくなります。
セルフホスト環境を使う場合は、導入版や構成も確認してください。Cloud向けの現行資料と、過去の版で報告された挙動が一致するとは限りません。古い記事の画面を再現するために設定を変えるより、自分の版と実出力を記録し、利用している版の資料や変更履歴と照合します。
File・Array[File]・Stringを、変数の選択画面で確認する
ファイルが得られた後も、後段の入力型が合う必要があります。一つのファイルを受けるFileと、複数のファイルを受けるArray[File]は同じではありません。Stringは文字列であり、文書のURLを含む場合でもFile変数とは別です。
例えば、取得したfilesが配列で、後段を単一ファイル入力にしているなら、どの一つを渡すのかを決める必要があります。先頭を選べばよいと決める前に、件数が0・1・複数の場合を確認します。一つの予定だったのに複数ある場合は、先頭だけで残りを捨ててよいのかを考えてください。
Document Extractor公式資料では、単一ファイル入力のtextはString、複数ファイル入力のtextはArray[String]になると説明しています。ファイルを渡せた後にも、抽出結果の型が変わります。取得段階、ファイル入力、抽出した文字列という三つの接続を順番に確認します。
文字列へ変換して見た目を合わせることも、ファイルを取得する処理ではありません。コードノードで任意の辞書を作ってFileと名付けても、Difyが管理する実ファイルと同じになるわけではありません。ファイル変数は、実際にファイルを取得したノードや正規の入力から選択してください。
Outputへ渡す値と、画面で見えるファイルを区別する
Workflowの結果を呼び出し元へ返す場合は、Outputノードで返す変数を指定します。公式のOutput資料では、FileやArray[File]を含む型を返せると説明しています。HTTPノードが成功したことと、目的の値が利用者へ返ったことは別の確認です。
確認用のWorkflowでは、例えばdownloaded_filesという出力名に、HTTPノードの実際のファイル出力を指定する方法があります。APIを使うなら、最終結果のoutputsに何があるかも確認します。Chatflowの応答はAnswerノードで扱うため、WorkflowのOutput設定と同じ手順として混ぜないでください。
Workflowをツールとして公開する場合、公式資料ではtext・files・jsonが組み込み出力用の予約名とされています。ファイルを返すから出力名もfilesに固定する、という考え方は避け、用途が伝わる固有の名前を選びます。どの公開形式かも確認対象になります。
ファイル変数を返せても、文書の内容が正しいことや、利用者が期待する形式で開けることまでは別途確認が必要です。名前、件数、形式、開けるか、期待する見出しがあるかを、小さな確認用文書で調べると、取得後の見落としを減らせます。
架空の5応答で、次に確認する場所を練習する
PDF・JSON・HTML・空応答・403を、別のケースとして用意する
以下は、実行結果の見方を練習するための架空データです。files内の辞書は説明用のメタ情報であり、Difyへ投入して使える実ファイルではありません。URLのexample.testも教材用で、アクセスしません。外部サービスの認証情報は不要です。
import json

cases = {
    "pdf": {
        "status_code": 200,
        "headers": {"content-type": "application/pdf"},
        "body": "", "files": [{"filename": "guide.pdf"}],
    },
    "json_url": {
        "status_code": 200,
        "headers": {"content-type": "application/json"},
        "body": json.dumps({"download_url": "https://files.example.test/guide.pdf"}),
        "files": [],
    },
    "html": {
        "status_code": 200,
        "headers": {"content-type": "text/html; charset=utf-8"},
        "body": "<html><body>Login required</body></html>", "files": [],
    },
    "empty": {
        "status_code": 200, "headers": {}, "body": "", "files": [],
    },
    "denied": {
        "status_code": 403,
        "headers": {"content-type": "application/json"},
        "body": json.dumps({"error": "not_allowed"}), "files": [],
    },
}
assert len(cases) == 5
期待する確認先を、実行前に決めます。pdfは「ファイルを渡す後段」、json_urlは「APIの取得手順」、htmlは「取得先」、emptyは「空応答の仕様」、deniedは「HTTPの権限・アクセス方法」です。同じfilesが空という観測でも、四つのケースで次に調べる対象が違います。
まず観測結果を分類する練習にすることで、実在のAPIへ何度も再送してから原因を考える流れを避けられます。後段のプロンプトを修正する前に、何が届いたかを確認するという順序を身に付けてください。
成功コードとfilesを先に見て、本文の確認へ進む
def next_check(observed):
    status = observed["status_code"]
    if not 200 <= status < 300:
        return "http_access"
    if observed["files"]:
        return "file_input"
    body = observed["body"]
    if not body.strip():
        return "empty_response"
    content_type = observed["headers"].get("content-type", "").lower()
    if "application/json" in content_type:
        return "json_contract"
    if "text/html" in content_type:
        return "request_target"
    return "text_response"

routes = {name: next_check(value) for name, value in cases.items()}
assert routes == {
    "pdf": "file_input", "json_url": "json_contract",
    "html": "request_target", "empty": "empty_response",
    "denied": "http_access",
}
これはDifyのファイル検出を再現する関数ではありません。すでに得られたと仮定した観測結果を、次の確認先へ分ける教材です。実際にDifyがどこへ値を入れたかは、ノードの実出力で確認します。この違いを残すと、教材の条件分岐が動いたことを、Dify実機の検証と混同せずに済みます。
この順序では、403を先に分けるため、エラーJSONを正常な文書情報として扱いません。また、filesに内容がある場合はbodyの空欄だけで失敗にしません。一方、成功コードでもbodyとfilesが両方空なら、対象なしや空応答の仕様を調べるため、成功した文書取得とは区別します。
実務へ移す際は、サービスの仕様が優先です。例えば応答コード202が処理受付を意味するAPIなら、2xxを一括で文書取得完了と判定する設計は足りません。この関数は完了判定ではなく、どの情報を次に確認するかの入口です。
URL入りJSONを読み、取得済みという説明へ飛ばない
metadata = json.loads(cases["json_url"]["body"])
download_url = metadata["download_url"]
assert isinstance(download_url, str)
assert download_url.endswith(".pdf")
assert cases["json_url"]["files"] == []
この時点で確認できたのは、「JSONにPDFらしいURL文字列がある」ということです。そのURLで本体を取得できること、取得してよい権限があること、文書が空でないことは確認していません。メタ情報を取得できたという結果を、文書取得済みと報告しないでください。
二段階の取得が必要なAPIなら、最初の応答を解析する処理と、その結果に基づいて取得する処理を分けます。入力された任意のURLをそのまま呼ぶ実装ではなく、利用を許可したサービスの公式手順と対象を確認します。再取得する前には、有効期限やアクセス方法が変わっていないかも見ます。
文書閲覧ページのURLだけを持っている場合は、公式のエクスポートやダウンロード機能があるかを調べます。ページの制限を回避するためにログイン情報を別の場所へ貼り付けたり、証明書の検証を無効にしたりする対処へ進まないでください。正規の取得方法が確認できない場合は、その段階で内容未確認と記録します。
一つのファイルを選ぶ前に、0件・1件・複数件を比較する
後段が単一ファイルを求める場合の判断も、小さい例で確認できます。以下も架空のメタ情報です。件数が一つのときだけ選び、0件や複数件では確認が必要という練習にします。実ファイルの型を作る処理ではありません。
def choose_single_metadata(items):
    if len(items) != 1:
        return None
    return items[0]

assert choose_single_metadata([]) is None
assert choose_single_metadata([{"filename": "a.pdf"}]) == {"filename": "a.pdf"}
assert choose_single_metadata([
    {"filename": "a.pdf"}, {"filename": "b.pdf"}
]) is None
複数件を処理したい目的なら、配列を受ける後段や、ファイルごとの処理を選びます。単一入力へ合わせるために先頭だけを残すと、残りのファイルを確認せずに捨てることになります。件数を減らす必要があるなら、選択条件を決め、その条件から外れたファイルも記録します。
文書抽出まで進めた後は、抽出されたtextの件数と、元ファイルの件数を照合してください。テキスト付きPDFとスキャン画像では、文字を取得できる前提も異なります。ファイルの取得が成功してから、文字抽出の問題へ進むと、確認する範囲を小さくできます。
例えば二つの文書から二つの文字列が返ったなら、どちらがどのファイル由来かを保持します。二つを連結しただけでは、後の要約から元文書へ戻りにくくなります。名前と本文の対応、空文字の有無、見出しや件数が合うかを、一組ずつ確認します。
最後に、取得結果と未確認部分が分かる確認票を残す
確認票には、実行日、Cloudかセルフホストか、導入版が分かる場合は版、対象の取得手順、HTTP状態コード、主要ヘッダー、bodyの種類、filesの件数、後段の期待型、結果を残します。実際の本文や認証情報をそのまま保存する必要はありません。
例えば「200、application/json、files 0件、bodyは取得URLを返すJSON。文書本体はまだ取得していない」と書けば、後の担当者も次の確認が分かります。「PDF取得エラー」という一言だけでは、JSONの解析、ファイルの取得、文字抽出のどこを修正すべきか分かりません。
逆に「200、files 1件、body空、後段は単一File入力」と分かれば、次は配列からどの値を接続したかを調べます。すべての失敗をプロンプトの問題として扱わず、取得したものの形と後段が要求する形を照合することが、この練習の到達点です。
独学で質問する場合は、機密を含まない再現用文書と、この確認票を用意すると状況を伝えやすくなります。講座を検討する場合も、生成AIの操作、Difyのノード接続、外部APIの仕様確認、個別課題への質問がどこまで対象かを分けて確認してください。受講料以外のツール費や、使えるサポート期間も申込前の確認事項です。
Difyを業務フローへつなぐところまで学びたい初学者は、バイテックAIスクールも比較対象です。公式の講座案内では、Difyによる申請フローやレポート自動化などを扱うコースを紹介しています。HTTP応答の調査や個別APIの接続をどこまで相談できるか、受講総額・質問できる期間・別途必要なツール費を申込前に確認してください。(公式確認:2026年11月1日)
よくある質問
Q. URLの末尾が.pdfならfilesに入りますか?
末尾だけでは判断できません。実際の応答がJSONやHTMLなら、PDF本体を受け取っていない可能性があります。状態コード、ヘッダー、body、filesを一緒に確認します。
Q. bodyが空なら取得失敗ですか?
ファイルとして認識され、files側へ内容が入っている場合があります。bodyだけで判定せず、filesの件数と後段の入力型も確認してください。
Q. URL文字列をFileという名前へ変えれば接続できますか?
変数名の変更は型変換やダウンロードではありません。Difyが管理する実際のファイル変数を、取得ノードや正規のファイル入力から選びます。
Q. 200なのにHTMLが返ります。PDF抽出器を直すべきですか?
まず取得先を確認します。閲覧ページやログイン案内を受け取っている可能性があり、ファイル本体を取得できてから文字抽出を調べる方が原因を分けやすくなります。
Q. ファイルが複数ある場合は先頭を使えばよいですか?
先頭を選ぶ仕様かを先に決めます。複数件をすべて処理する目的なら、配列を受ける後段やファイルごとの処理を検討し、元の件数と結果を照合してください。
Q. このPython例はDify内部と同じ判定ですか?
異なります。架空の観測結果から次の確認先を選ぶ教材です。Dify CloudでHTTPやLLMを実行した検証ではなく、実際のファイル検出と出力型は利用環境で確認します。
次の確認へ進むときは、HTTPのJSONボディと型、タイムアウト後の再試行前の確認、PDFの文字・列・単位の照合、配列を処理するイテレーション、Difyを独学する順番と講座の比較を参照してください。