
pandasで複数の行条件を組み合わせるときは、各条件を括弧で囲み、かつは&、またはは|でつなぎます。 andやorは、一つの真偽値を判断するPythonの演算子です。列から作った複数行の判定を、そのまま一つのTrue/Falseへ変えようとするとエラーになります。
対象は、CSVやExcelの表から「この条件に合う行だけ」を選ぶ練習中の人です。Pythonの比較演算とDataFrameの列指定が分かれば始められます。今回は架空の申請一覧8行で、承認済み・金額5000以上という条件を調べます。実在の申請を承認したり送信したりするコードではありません。
公式資料の確認日:2026年11月1日。例はpandas 2.2.3と3.1.0で実行確認しました。金額には欠損を保持できるInt64、文字列にはstringを明示し、読み込み時の型推測に結果を依存させません。
複数条件のエラーを、行ごとの判定と全体の判定に分ける
and・orは、列全体を一つの真偽値にしようとする
df["amount"] >= 5000の結果は、通常、一つの真偽値ではありません。表の各行に対応する判定を持ったSeriesです。8行あれば8個の判定ができます。これをPythonのandへ渡すと、列全体をTrueと呼ぶ条件が決まっていないため、The truth value of a Series is ambiguousという種類のエラーになります。
エラーにany()やall()という候補が書かれていても、そのまま付け足すのが修正とは限りません。行を残したいのに判定を一つへまとめると、元の目的が変わります。最初に「行ごとの一覧が欲しいか」「表全体に対して一つだけ答えが欲しいか」を分けてください。
以下は誤りを再現するための短い例です。二つのSeriesをandで結んでいます。例外を捕まえているのは、後の練習を続けるためです。実務の処理で、すべてのValueErrorを握りつぶすための書き方ではありません。
import pandas as pd

small = pd.DataFrame({"amount": [6000, 1000], "state": ["ok", "hold"]})
try:
    small[(small["amount"] >= 5000) and (small["state"] == "ok")]
except ValueError as exc:
    assert "truth value" in str(exc)
else:
raise AssertionError("この例では真偽値エラーを想定しています")orやnotも、Seriesを使う通常のPython式では同じ区別が必要です。データが一行になった日だけ挙動が変わるような修正を避けるため、件数にかかわらず、行判定と全体判定の役割を明示します。
&・|でつなぐ前に、一つずつ条件を括弧で囲む
行ごとの「かつ」には&、「または」には|、「反転」には~を使います。比較式それぞれを括弧で囲むことが要点です。small["amount"] >= 5000 & small["state"] == "ok"のように書くと、比較より先に別の計算が行われ、型エラーや意図しない式になる可能性があります。
括弧は見た目を整える記号ではなく、どこまでを一つの条件として先に評価するかを示します。公式のIndexing and selecting dataでも、この優先順位を説明しています。エラー文だけを検索して記号を置き換えるより、条件を分けて確認すると原因を追いやすくなります。
is_large = small["amount"] >= 5000
is_ok = small["state"] == "ok"
result = small.loc[is_large & is_ok]
assert result.index.tolist() == [0]

either = small.loc[(small["amount"] >= 5000) | (small["state"] == "hold")]
assert either.index.tolist() == [0, 1]名前付きの条件に分けると、「金額の比較が合っているか」「状態の表記が合っているか」「最後の結び方が合っているか」を別々に調べられます。maskが長くなったときは、演算子を増やす前に業務上の意味が伝わる名前へ分けると、翌月に条件を変える際も確認しやすくなります。
ただし、名前を付ければどんな式でも同じになるわけではありません。別の表で作った条件を流用すると、インデックスの対応も問題になります。本稿の例は、すべて抽出元と同じ表から作った条件を使います。並べ替えや行削除の後は、その時点の表で条件を作り直すことを基本にしてください。
行を抽出する.locと、一件でもあるかを調べるanyを使い分ける
small.loc[is_large & is_ok]は、条件を満たした行を返します。一方、(is_large & is_ok).any()は、一件でも該当するかを一つの真偽値で返します。抽出した一覧と、一覧の有無を知らせるメッセージは、必要とする値の形が異なります。
mask_small = is_large & is_ok
assert bool(mask_small.any()) is True
assert bool(mask_small.all()) is False
assert len(small.loc[mask_small]) == 1all()は、対象とした全要素が条件を満たすかという別の質問です。例えば「抽出対象が存在するか」の確認にall()を使うと、一行でも対象外があるだけでFalseになります。担当者へ一覧を渡したい場面で、こうした全体判定を行抽出の代わりにしないでください。
空の表にも注意します。空のBoolean Seriesに対するany()はFalse、all()はTrueになります。データが一件もないのに「全件確認済み」と読み替えないよう、入力件数も一緒に確認します。ここでは、件数がゼロかどうかと、値が条件を満たすかどうかを別々に記録します。
欠損を含む場合、any()やall()の既定動作には欠損を除く扱いも関係します。今回の最終判定は、未知を先に保留へ分けてから数えます。「Trueが見つからない」と「すべてFalseと確かめた」は同じ説明ではありません。
&と|が混ざる条件は、日本語のまとまりを先に決める
「承認済みで5000以上、または緊急」と「承認済みで、5000以上または緊急」は、似た言葉でも異なる条件です。前者は未承認の緊急行を含み、後者は含みません。エラーにならず、結果だけが変わるため、構文エラーより気付きにくい場合があります。
条件を共有する際は、「承認済み」をどこまで要求するかを明示します。金額条件と緊急条件を一つの括弧へ入れるのか、承認と金額だけを一つへ入れるのかを、先に例のIDで合意してください。記号の優先順位を覚えている人だけが読める式にする必要はありません。
| 目的 | 書き方の形 | 得られるもの |
|---|---|---|
| 二条件とも満たす行 | (条件A) & (条件B) | 行ごとの判定 |
| どちらかを満たす行 | (条件A) | (条件B) | 行ごとの判定 |
| 該当行が一件でもあるか | mask.any() | 一つの真偽値 |
| 全行が条件を満たすか | mask.all()と入力件数の確認 | 一つの真偽値と件数 |
後半では同じ8行を使い、二通りの括弧でIDが変わることを実行します。正しい条件をコードの書き方だけで決めるのではなく、「このIDを含めるのか」という具体的な判断に戻す練習です。
queryの中のandと、通常のPython式のandを混ぜない
DataFrame.query()は、条件の文字列を専用の仕組みで解釈するメソッドです。既定のpandasパーサーでは、文字列内にandやorを書けます。その例を、通常のdf[...]へそのまま移すと、前述のSeriesの真偽値エラーになることがあります。
q = small.query('amount >= 5000 and state == "ok"', engine="python")
assert q.index.tolist() == result.index.tolist()このコードは、編集者が固定した条件文字列だけを使っています。query()は任意のコードを実行し得ると公式API資料が注意しているため、読者や外部から受け取った文字列をそのまま渡す実装には使いません。入力された値を比較したいだけなら、列の比較とマスクを組み立てる方法を検討してください。
queryへ書き換えれば、欠損・型・条件の意味まで自動的に直るわけでもありません。まず短い通常式で期待するIDが得られることを確かめ、その後で読みやすさのために書式を選びます。両方を混ぜて使うチームでは、どこが文字列の式なのかもレビュー対象になります。
申請一覧8行で、抽出・対象外・判定保留を検算する
金額の境界、未承認、欠損を含む8行を用意する
架空の申請番号A01〜A08を用意します。条件は「承認済みで、金額が5000以上」です。境界の5000を含むこと、未承認の高額行を含めないこと、金額が不明な承認済み行を勝手に対象外と確定しないことを、実行前の確認条件にします。
df = pd.DataFrame({
    "id": ["A01", "A02", "A03", "A04", "A05", "A06", "A07", "A08"],
    "amount": pd.Series([5000, 4999, 8000, pd.NA, 9000, 0, 6000, 1000], dtype="Int64"),
    "state": pd.Series(["ok", "ok", "hold", "ok", "ok", "hold", "hold", "ok"], dtype="string"),
    "urgent": [False, True, True, False, False, False, True, False],
})
assert len(df) == 8
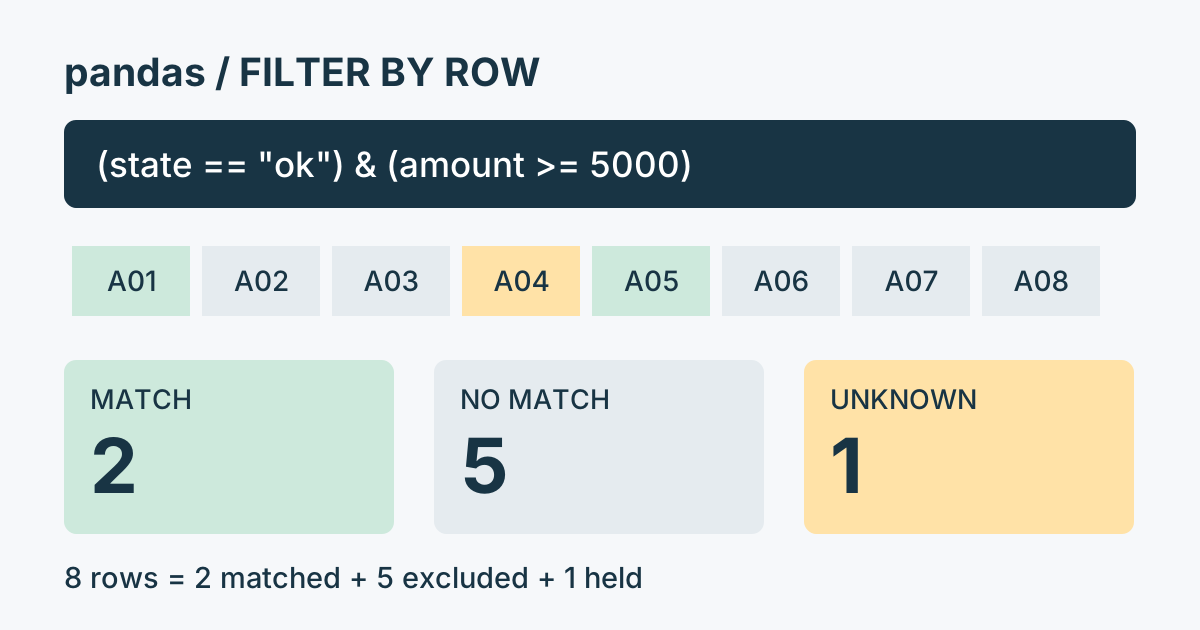
A01は金額が境界ちょうどなので対象、A02は一円足りないので対象外です。A03とA07は高額・緊急でも状態がholdのため、この条件では対象外です。A04は承認済みですが金額が不明なので、確認待ちの候補になります。A05は二条件を満たします。
この小さな表には、大量データで見落としがちな違いを意図して入れています。正常例だけで動作を確認するより、境界・対象外・欠損を一つずつ含めると、括弧を直した結果が業務上の意味に合うかを説明できます。ここでの金額や申請番号は説明用であり、実際の審査基準ではありません。
マスクを表示し、2件の対象と1件の保留を分ける
mask = (df["state"] == "ok") & (df["amount"] >= 5000)
chosen = df.loc[mask.fillna(False)]
held = df.loc[mask.isna()]
excluded = df.loc[(~mask).fillna(False)]

assert chosen["id"].tolist() == ["A01", "A05"]
assert held["id"].tolist() == ["A04"]
assert excluded["id"].tolist() == ["A02", "A03", "A06", "A07", "A08"]
assert len(chosen) + len(held) + len(excluded) == len(df)今回の比較は、欠損を保持するBoolean型の判定になります。pandasのNullable Boolean資料では、行抽出に使うBoolean配列のNAはFalseとして扱われることが説明されています。そのため、抽出結果だけを見るとA04が外れた理由を見失います。
この例ではfillna(False)を抽出操作に使いながら、元のmaskに残ったNAを別の表へ取っています。金額そのものをゼロへ変更したわけではありません。「今回は選ばない」と「条件を満たさないと確認できた」を区別するための書き方です。
保留の扱いは仕事の仕様によります。未知をすべて対象へ含める運用も、いったん止めて確認する運用もあり得ます。本稿は、未知を保留として見える場所へ残す練習です。どの扱いを選んでも、実行前に決め、件数とIDに反映されているかを確かめてください。
欠損は、条件を組み合わせた後の判定も確認する
欠損がある行はすべて保留、というルールとも限りません。三値の論理では、False & NAはFalseです。一方、True & NAはNAになります。「状態が未承認なら金額が不明でも対象ではない」と決めている場合と、「承認済みだが金額は不明」の場合を分けられます。
logic = pd.Series([True, False], dtype="boolean") & pd.NA
assert logic.isna().tolist() == [True, False]
assert bool(logic.iloc[1]) is False

empty = pd.Series([], dtype="boolean")
assert bool(empty.any()) is False
assert bool(empty.all()) is True
保留件数を調べる場所にも違いがあります。金額列の欠損件数は、元データで金額が不明な件数です。最終マスクのNA件数は、今回の条件では判定できなかった件数です。条件が増えると、この二つは一致しないことがあります。
例えば未承認の行にも金額欠損を追加した場合、金額欠損は増えても、最終マスクの保留は増えない可能性があります。これは欠損が消えたのではなく、別の条件で対象外と決まったためです。報告には、元データの不明値と今回の判定保留のどちらを数えたかを添えます。
逆に、欠損を文字列の空欄や数値0へ一括変換すると、この区別が消えます。エラー解消のための型変換を先に実行するより、現状の型と未知の意味を確認してください。数値へ読み替える必要がある場合は、変換できなかった行を先に一覧へ残すと、後から追えます。
二通りの括弧を比べ、抽出IDと分母を残す
ok = df["state"] == "ok"
large = df["amount"] >= 5000
urgent = df["urgent"]

approved_and_either = ok & (large | urgent)
approved_large_or_urgent = (ok & large) | urgent

left_ids = df.loc[approved_and_either.fillna(False), "id"].tolist()
right_ids = df.loc[approved_large_or_urgent.fillna(False), "id"].tolist()
assert left_ids == ["A01", "A02", "A05"]
assert right_ids == ["A01", "A02", "A03", "A05", "A07"]
assert set(right_ids) - set(left_ids) == {"A03", "A07"}
前者は承認済みをすべての対象に要求するため3件です。後者は緊急なら未承認でも通るため5件になります。どちらも式としては実行できます。記号の使い方を直せた段階で終わると、この2件の違いを見落とします。
比較するときは、行数だけでなく差分のIDを出します。別のミスで一件入り一件抜けると、合計件数が同じでも結果は違うからです。条件を変更する前後で、追加されたID・外れたID・保留のIDを見比べると、変更の意味を具体的に説明できます。
一覧を人へ渡すなら、「8行を入力し、承認済みかつ5000以上で対象2、対象外5、保留1。対象A01・A05、保留A04」といった確認メモを添えます。これなら、対象2件という結果だけを見た人も、何を分母として、何が残ったかを確かめられます。
次の練習は、仕様を一文で説明してから条件を変える
復習には、条件を一か所だけ変える練習が向いています。例えば「5000以上」を「5000より大きい」へ変えるとA01が外れ、対象はA05だけになります。先に予想したIDを書き、実行結果が一致するかを確認してください。複数の条件を同時に変えると、どの変更で件数が動いたか追いにくくなります。
strict = (df["state"] == "ok") & (df["amount"] > 5000)
assert df.loc[strict.fillna(False), "id"].tolist() == ["A05"]
次に、A04の金額を確認できたと仮定して6000へ変えた別の表を作ると、対象へ移るはずです。元の表を保存し、仮の修正案を別変数で試せば、保留解消による変化と抽出条件の変更を分けて比べられます。実在の業務記録を更新する前に、こうした小さな例で仕様の理解を合わせます。
独学で詰まった場合は、完成したコード全体より、入力8行・条件の日本語・期待したID・実際のIDをそろえて質問すると状況が伝わります。講座を比較する場合も、Pythonの文法だけか、pandasによる前処理や自作例への質問まで扱うかを確認してください。学習目的、前提知識、個別質問の範囲、受講総額を分けて検討すると選びやすくなります。
Pythonを基礎から学び直し、業務データの前処理へ進みたい人は、Python Winnerも比較対象になります。公式のPythonマスター案内では、基礎・応用とマンツーマンレッスンを紹介しています。本稿のようなpandasの自作例への質問にどこまで対応するか、希望する講座の範囲・受講総額・サポート期限を申込前に確認してください。(公式確認:2026年11月1日)

よくある質問
Q. andを&へ置き換えるだけで直りますか?
比較式ごとの括弧も必要です。さらに、かつとまたはが混ざる条件では、業務上のまとまりを括弧で明示し、抽出IDを確認してください。
Q. エラーにanyと書かれているので付ければよいですか?
anyは一件でもTrueがあるかを一つの真偽値へまとめます。行を抽出したい場合とは目的が違います。行ごとのマスクを作り、必要な場面だけ全体判定へ使います。
Q. queryではandが使えるのはなぜですか?
queryは文字列を専用のパーサーで解釈します。通常のPython式とは扱いが違います。外部入力の文字列をそのままqueryへ渡さないことにも注意してください。
Q. 欠損の行は自動的に対象外ですか?
NAを含むBooleanマスクで行抽出するとNAはFalseとして扱われます。ただし不明値が対象外と確定したわけではないため、例では元のマスクから保留を分けています。
Q. 空の表でallがTrueでもよいのですか?
空のBoolean SeriesではallはTrueです。入力が存在することを表す値ではありません。確認済み件数の報告には元の件数や空かどうかを別に添えてください。
Q. 何を保存すると条件変更を確認しやすいですか?
元の件数、条件の文章と式、対象・対象外・保留の件数とIDを残します。合計だけでなく、変更前後で追加・除外されたIDを比べると意味を確認できます。
関連する練習として、候補一覧との一致はisinの型と先頭ゼロ、文字列条件はstr.containsの欠損と正規表現、数値比較の準備はto_numericで変換できない値の確認へ進めます。抽出後の更新を学ぶ場合はCopy-on-Writeとfillna、学習順を決める場合はPythonによるCSV分析の始め方も参照してください。