
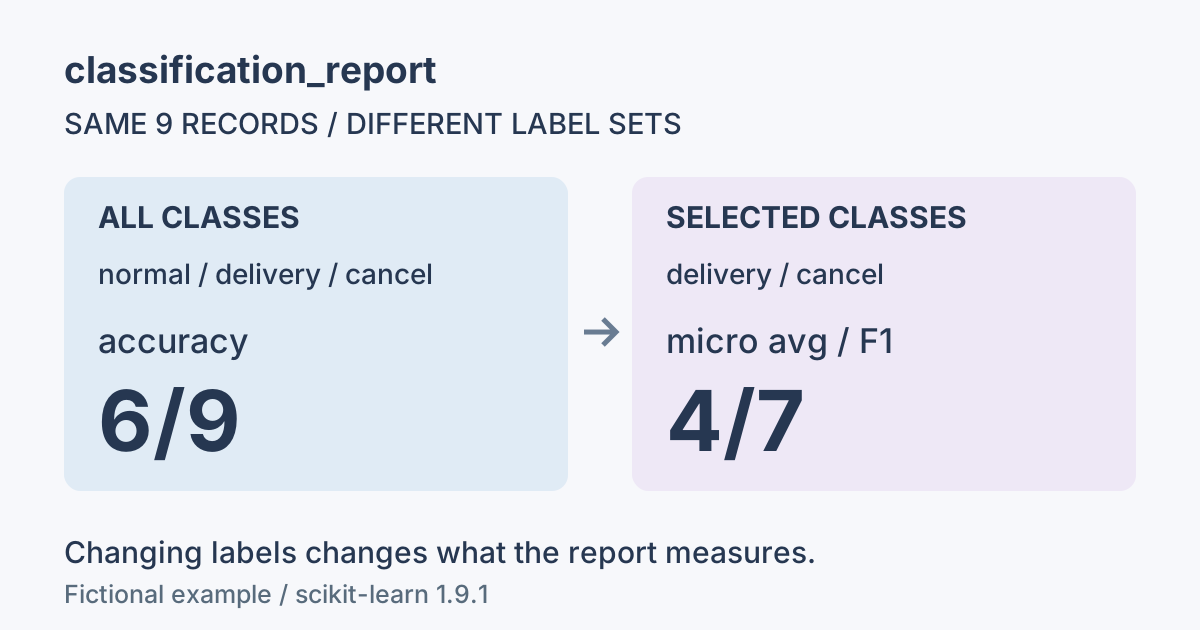
単一ラベル分類で、出現したクラスをすべて評価すると、micro平均の適合率・再現率・F1はaccuracyと一致します。classification_reportでは、その重複を避けてaccuracyの行が表示されます。 micro avgがないという理由だけで、計算に失敗したとは判断できません。
対象は、分類の学習を始め、教材と自分の評価表で行名が違うことに戸惑っている人です。Pythonのリストと関数呼び出しが分かれば例を動かせます。今回は、通常・配送・取消という三種類の架空の問い合わせ9件を使います。予測も説明のために手で作り、実在するモデルの性能を測った数値ではありません。
公式資料・実行環境の確認日:2026年11月1日。例はscikit-learn 1.9.1で実行確認しました。ここで扱うのは、一件につき一つのクラスを持つ単一ラベル分類です。一件に複数のラベルを付けるマルチラベル分類は、後半で違いを整理します。
micro avgが表示されない理由を、全クラスと一部のクラスで比べる
最初に、正解・予測・labelsの三つを確認する
classification_report(y_true, y_pred)へ渡す最初の二つは、同じ順番で対応する正解と予測です。labelsは、どのクラスについて評価するかを指定します。表示名を変えるtarget_namesとは役割が違います。micro avgを出すためだけにlabelsを適当に変えると、比較したい対象まで変わります。
公式のclassification_report資料は、通常の全クラス評価ではmicro平均がaccuracyと同じになるため省略されると説明しています。まず分類の形式と出現クラスを確認し、教材と自分の入力条件が同じかを調べてください。
import math
from collections import Counter
from sklearn.metrics import (
    accuracy_score, classification_report, precision_recall_fscore_support,
)

y_true = ["normal"] * 5 + ["delivery"] * 3 + ["cancel"]
y_pred = ["normal", "normal", "delivery", "normal", "normal",
          "delivery", "normal", "delivery", "normal"]
labels = ["normal", "delivery", "cancel"]

assert len(y_true) == len(y_pred) == 9
assert Counter(y_true) == {"normal": 5, "delivery": 3, "cancel": 1}
assert Counter(y_pred) == {"normal": 6, "delivery": 3}
この表では取消の正解が一件ある一方、取消という予測は一件もありません。全体の正解数を調べる話と、取消の見逃しを調べる話は別です。平均値の行だけを見ると、このような少数クラスの状況が見えにくくなるため、クラスごとの件数も残します。
実際のデータでは、配列の長さが同じでも対応順が崩れている可能性があります。予測を並べ替えてから正解と比較しないよう、元のレコードIDで対応を確認してください。今回はリストの順を固定し、ID1〜9の順に並んだ例として扱います。
全クラスではaccuracyが表示され、micro平均と一致する
full = classification_report(
    y_true, y_pred, labels=labels, output_dict=True, zero_division=0,
)
assert "accuracy" in full
assert "micro avg" not in full
assert math.isclose(full["accuracy"], 6 / 9)

p, r, f1, _ = precision_recall_fscore_support(
    y_true, y_pred, labels=labels, average="micro", zero_division=0,
)
assert all(math.isclose(value, 6 / 9) for value in [p, r, f1])
なぜ一致するのでしょうか。一件につき正解も予測も一つで、全クラスを数える場合、一つの誤分類は、予測したクラス側では偽陽性、正解クラス側では偽陰性になります。正解が6件、誤りが3件なら、合算したTPは6、FPは3、FNは3です。
そのためmicro適合率は6÷9、micro再現率も6÷9になり、二つから求めるmicro F1も6÷9です。accuracyは正解6件を全9件で割った値なので一致します。今回サンプル重みは指定していません。表示されていないmicro平均を別関数で求めることはできますが、全体評価の新しい情報が一つ増えるわけではありません。
画面の表示は、通常、小数点以下二桁などに丸められます。0.67という表示だけを比較するのではなく、入力件数と6/9という元の比率も保持すると、表示桁数を変えた場合にも確認できます。
labelsを配送・取消へ絞ると、micro avgが現れる
selected_labels = ["delivery", "cancel"]
partial = classification_report(
    y_true, y_pred, labels=selected_labels,
    output_dict=True, zero_division=0,
)
assert "accuracy" not in partial
assert "micro avg" in partial
assert math.isclose(partial["micro avg"]["precision"], 2 / 3)
assert math.isclose(partial["micro avg"]["recall"], 2 / 4)
assert math.isclose(partial["micro avg"]["f1-score"], 4 / 7)
assert partial["micro avg"]["support"] == 4
配送の正解3件のうち2件を正しく予測しています。取消の正解1件は通常へ誤分類しています。選んだ二クラスを合算するとTPは2、FPは1、FNは2です。precisionは2÷3、recallは2÷4、F1は4÷7になります。
ここでのsupportの4は、正解が配送か取消である件数です。「計算に影響した行は4件だけ」という意味にはなりません。正解が通常でも配送と予測した行は、配送の偽陽性としてprecisionの分母へ影響します。
labelsでクラスを選ぶことと、正解がそのクラスの行だけを事前に残すことは違います。後者では、選択外の正解から選択内への誤予測が評価から消えてしまいます。レポートの行を整理したいだけなのか、評価するタスク自体を変えたいのかを先に決めましょう。
正解クラスで行を絞ると、別の評価になる
keep = [t in selected_labels for t in y_true]
true_only = [t for t, use in zip(y_true, keep) if use]
pred_only = [v for v, use in zip(y_pred, keep) if use]
p2, r2, f2, _ = precision_recall_fscore_support(
    true_only, pred_only, labels=selected_labels,
    average="micro", zero_division=0,
)
assert math.isclose(p2, 1.0)
assert math.isclose(r2, 0.5)
assert math.isclose(f2, 2 / 3)
正解が配送か取消の行だけを残すと、通常から配送へ誤分類した一件がなくなります。その結果、この例のmicro precisionは1.0へ変わります。予測そのものを改善していないのに、分母を減らしたことで値が変わった例です。
このような絞り込み自体が誤りというわけではありません。例えば、対象部署の入力だけを評価するという別の設計なら、その集団を作る操作が必要です。ただし、その結果を元の全9件の評価と同じものとして比較しないでください。対象集団の定義、残した件数、除いた件数を明記します。
今回の目的は、micro avgという行がない理由の確認です。その目的なら、データを削る前に全クラスのaccuracyとmicro平均の関係を照合すれば足ります。行名を見たいがための行削除で、評価対象を変える必要はありません。
未出現のクラスを加える場合は、現行版の結果を確かめる
labelsへotherを追加すると、micro avgが現れると思うかもしれません。古い版を使った説明や古い出力例では、そうした結果を見ることがあります。今回確認した1.9.1では、labelsが実際に出現するクラスをすべて含む上位集合であれば、単一ラベル分類の全体行はaccuracyのままです。
extended = classification_report(
    y_true, y_pred, labels=labels + ["other"],
    output_dict=True, zero_division=0,
)
assert "accuracy" in extended
assert "micro avg" not in extended
assert extended["other"]["support"] == 0
assert math.isclose(extended["accuracy"], 6 / 9)この判定は、scikit-learn 1.9.1の公開実装と手元での実行を照合しています。正解に出ないが予測には出るクラスも、出現クラスの確認に含める点が大切です。正解側の種類だけを見て「全部含めた」と判断しないでください。
ただし、未出現クラスを加えても何も変わらないわけではありません。zero_division=0ではotherの各指標が0となり、クラスを等しく扱うmacro平均へ影響します。行名が同じでも平均の対象が増えています。追加クラスを含む評価が必要かを、モデルに期待する分類の一覧と合わせて決めます。
平均値と出力形式を確認し、比較できる評価表を残す
macroとweightedの違いを、クラス別の件数で確認する
macro平均は、クラス別の値を同じ重みで平均します。weighted平均は、正解データの各クラスの件数で重み付けします。今回の正解件数は通常5、配送3、取消1です。通常を比較的よく当て、取消を一件も当てていないため、二つの平均には差が出ます。
assert math.isclose(full["normal"]["f1-score"], 8 / 11)
assert math.isclose(full["delivery"]["f1-score"], 2 / 3)
assert full["cancel"]["f1-score"] == 0
assert math.isclose(full["macro avg"]["f1-score"], 46 / 99)
assert math.isclose(full["weighted avg"]["f1-score"], 62 / 99)
micro、macro、weightedは、値の大小でどれか一つを採用するための候補ではありません。何を一つの単位としてまとめるかが違います。取消を見逃したくないなら、weightedの全体値だけで結論を出すと、正解件数の少ない取消の問題が見えにくくなります。
| 集計 | F1の値 | 確認する分母・対象 |
|---|---|---|
| 全クラスのmicro | 6/9 ≒ 0.667 | 全クラスのTP・FP・FNを合算 |
| 全クラスのmacro | 46/99 ≒ 0.465 | 三クラスを同じ重みで平均 |
| 全クラスのweighted | 62/99 ≒ 0.626 | 正解件数5・3・1で重み付け |
| 配送・取消のmicro | 4/7 ≒ 0.571 | 選択クラスのTP・FP・FNを合算 |
出現しないotherを加えた場合、今回のmacro F1は23/66になります。元の三クラス平均と四クラス平均を、モデルの良し悪しだけの差として比較しないでください。比較表に、labelsとクラス別supportを添える理由はここにあります。
zero_divisionで警告を消しても、予測が増えるわけではない
取消は正解が一件あるのに、取消という予測が一件もありません。そのため、取消のprecisionを計算する分母が0です。本稿では結果を比較しやすくするため、zero_division=0と明示しています。これはゼロ除算が起こる値を0として扱う指定で、予測器を修正する操作ではありません。
学習中は、警告を読んで「どのクラスで、どの件数が0なのか」を確認します。警告が消えたことを、少数クラスが検出できるようになったことと取り違えないでください。今回なら、取消の予測件数0は指定を変えても0のままです。
他の選択肢では平均の扱いも変わり得ます。例えば欠損として除外する指定を使うと、平均に参加する値が変わる場合があります。precision_recall_fscore_supportの公式説明を確認し、モデルや実行ごとに指定を変えないようにします。
評価表には、zero_divisionの指定も残します。「0は実際に計算して0だったのか」「分母0のため0として扱ったのか」が分かるよう、正解件数と予測件数を併記すると読み手が判断しやすくなります。今回の取消は、後者を含むことが分かります。
辞書出力のaccuracyは、クラス別の辞書とは形が違う
output_dict=Trueでは、クラス別やmacro avgの値は、precision・recall・f1-score・supportを持つ辞書です。一方、全クラス評価のaccuracyは、一つの数値として返ります。すべての行を同じ辞書だと思って処理すると、表への変換やキー参照で問題になります。
assert isinstance(full["accuracy"], float)
assert isinstance(full["normal"], dict)
summary = {
    "accuracy": full.get("accuracy"),
    "micro": full.get("micro avg"),
    "macro_f1": full["macro avg"]["f1-score"],
    "n_records": len(y_true),
    "labels": labels,
}
assert summary["micro"] is None
ここでmicroのNoneは、計算不能や未処理という意味ではありません。このレポートではaccuracyとして示され、micro avgというキーが存在しないことを表します。欠けているキーを0で補うと、「micro F1が0だった」という誤ったデータを作ってしまいます。
また、accuracyを表の一行へ並べるなら、クラス別のprecisionなどが空欄になることを説明します。一つの数値をすべての列へ複製してしまう変換では、support欄に0.666…といった値が入る可能性があります。見栄えよりも、各列に何の値を置いたかを確認してください。
CSVやJSONを後の処理へ渡す場合は、全体のaccuracyとクラス別指標を別の項目にする方法もあります。今回のsummaryのように、レポート上で省略されたキーを区別して保存すると、表示行の違いで処理が壊れにくくなります。
digitsとoutput_dict、単一ラベルとマルチラベルを区別する
文字列で出力する際のdigitsは、表示する小数点以下の桁数を指定します。output_dict=Trueでは、その丸め指定は値へ適用されません。印刷した0.67と、辞書に入った0.666666…は、異なるデータを評価したという意味ではありません。
rounded_display = classification_report(
    y_true, y_pred, labels=labels, digits=2, zero_division=0,
)
unrounded = classification_report(
    y_true, y_pred, labels=labels, digits=2,
    output_dict=True, zero_division=0,
)
assert "0.67" in rounded_display
assert math.isclose(unrounded["accuracy"], 2 / 3)
別の注意点は、マルチラベル分類です。一件が複数の正解ラベルを持つ場合、単一ラベル分類で説明した「誤り一件がFP一件・FN一件」という関係を、そのまま使えません。accuracyも、ラベルの集合が完全一致したかを見る扱いになります。
したがって、micro avgが表示されたからといって、labelsで一部クラスを選んだと断定はできません。入力が単一ラベルかマルチラベルかを先に確認します。公式のaccuracy_score資料も、マルチラベルの完全一致という意味を説明しています。
本稿は、入力が一次元のクラス一覧である単一ラベルの練習です。マルチラベルへ進むときは、ラベル数や一件ごとの正解数を含む別の確認票を作り、平均値だけを同じ欄へ並べないようにしてください。
版・評価対象・元の件数をそろえて、再現できる記録へまとめる
教材と表示が違ったら、最初にライブラリの版、分類の形式、出現クラス、labels、zero_division、出力形式を記録します。その上で、同じ9件を使った三つの例を動かすと、環境差なのか入力条件の差なのかを絞り込めます。
この例の確認票は、「1.9.1、単一ラベル、9件、全クラスnormal・delivery・cancel、正解件数5・3・1、zero_division=0」です。全体の正解は6件、microとaccuracyは6/9、配送・取消へ絞ったレポートのsupportは4です。取消の予測は0なので、平均値が示されても取消を検出できたとはいえません。
同じデータから作ったレポート同士でも、labelsや前処理が違えば直接比較できない場合があります。特に、正解ラベルで事前に行を絞った場合は、何件を外したかも残してください。小さい再現例で違いを確認してから、実際の評価データへ戻る方が原因を整理しやすくなります。
学習支援を検討する場合は、モデルの実装だけでなく、評価対象や指標の選択まで質問できるかを確認します。Python経験、数学・統計の前提、課題の添削範囲、受講総額は別々の確認項目です。今回の数値は教材用であり、受講後の到達度や転職・副業の成果を示すものではありません。
分類モデルの実装と評価を合わせて学びたい人は、Python Winnerの講座も比較できます。AI・機械学習マスターの公式案内で学習範囲を確認し、Python経験に合う入口、必要な数学の前提、指標の選択や自作コードへの質問対応、受講総額と支援期間を相談してください。本稿の特定の関数の添削対応を確認済みという意味ではありません。(公式確認:2026年11月1日)

よくある質問
Q. micro avgがないのはエラーですか?
単一ラベル分類で出現クラスをすべて評価すると、micro適合率・再現率・F1はaccuracyと一致し、accuracyの行で表示されます。省略だけでは計算失敗と判断できません。
Q. labelsへ存在しないクラスを加えるとmicro avgが出ますか?
今回確認した1.9.1では、出現クラスをすべて含む上位集合ならaccuracyのままです。ただし、未出現クラスの追加はmacro平均へ影響し得ます。版と実際の出力を確認してください。
Q. 一部のクラスへ絞ったmicro avgはaccuracyですか?
同じ意味とは限りません。この例では配送・取消のmicro適合率2/3、再現率1/2、F1は4/7で、全9件のaccuracy6/9とは異なります。
Q. supportは予測した件数ですか?
基本的には正解データにそのクラスがある件数です。今回の取消はsupport1ですが予測件数0です。両方を確認すると、分母0の指標の理由が分かります。
Q. output_dictでmicro avgがないとき0を入れてよいですか?
キーがないことと、評価値が0だったことは違います。accuracyとして表示されたケースなどを区別し、必要ならmicro平均を別関数で求めて条件付きで保存します。
Q. macroとweightedのどちらがよいですか?
クラスを同じ重みで見るか、正解件数で重み付けするかが違います。値が高い方を採用するのではなく、少数クラスを含めて何を評価したいかで決めます。
分類の基礎を続けるなら、混同行列の行・列とlabels、層化分割のクラス件数エラー、LabelEncoderと未出現ラベル、標準化を学習用データだけで行う方法、機械学習スクール受講前のPython・数学を参照してください。